

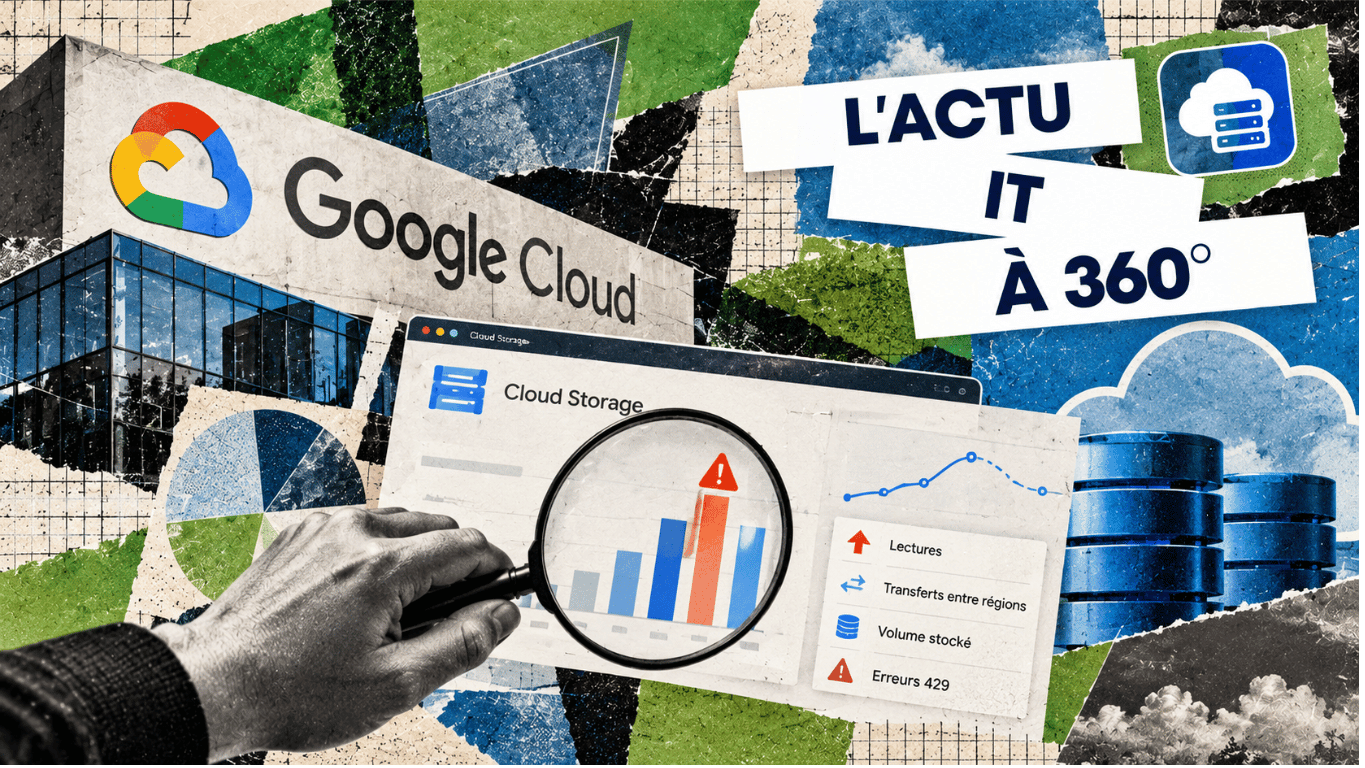
Une hausse des lectures, des transferts entre régions ou du volume stocké peut alourdir la facture cloud et perturber les applications. Avec Storage Intelligence advisor, Google propose une vue des changements inhabituels dans Cloud Storage et des pistes pour les examiner. Pour les entreprises, l’enjeu est de relier ces signaux aux traitements qui les produisent, puis de choisir une action.
Repère éditorial. Google situe la disponibilité générale de l’outil au 10 septembre 2026. Son billet présente les fonctions, mais ne fournit pas de mesure indépendante de leur taux de détection ni des économies obtenues.[1], [2]
Une surveillance intégrée au stockage cloud
Dans un billet publié le 25 septembre, Google présente Storage Intelligence advisor et des évolutions des opérations par lots. Les notes de version situent toutefois la disponibilité générale du conseiller au 10 septembre et les ajouts aux traitements par lots au 3 septembre. Cette chronologie précise la portée de l’actualité : le billet rassemble et illustre des fonctions déjà disponibles dans le mois.[1], [2]
Le conseiller affiche des métriques et des constats à l’échelle d’un projet, d’un dossier ou d’une organisation Google Cloud. Il fournit notamment une vue des volumes, des objets et des tendances, accompagnée de recommandations. Cette interface peut éviter de reconstruire un reporting spécifique pour les besoins qu’elle couvre. Son périmètre reste celui de Cloud Storage.[3]
Ce que le conseiller peut réellement repérer
Le catalogue documente quatre signaux : une hausse des opérations sur les classes Coldline ou Archive, une augmentation des erreurs 429 liées à la limitation des requêtes, un pic de transferts entre régions et une croissance du stockage supérieure à la tendance. Ces constats portent sur l’usage et la performance du stockage ; ils ne constituent pas une analyse de la qualité métier du contenu des fichiers.[4]
Google explique que la détection s’appuie sur l’activité habituelle du projet et sur des relevés quotidiens, avec des pics signalés sous 24 heures. Il faut donc intégrer ce délai au dispositif de supervision. Le billet décrit un suivi des écarts à examiner, sans apporter de mesure indépendante de son taux de détection ou des économies obtenues.[1]
Remonter du symptôme au traitement responsable
Cloud Storage organise les objets dans des conteneurs appelés buckets. Le conseiller permet de descendre vers les buckets concernés, puis vers les préfixes des objets et les comptes de service associés à la hausse des requêtes. Un compte de service représente généralement une application ou un traitement automatisé. Ces indications peuvent aider l’équipe IT à retrouver le processus à examiner.[5]
Prenons un exemple illustratif : un traitement analytique relit chaque jour des fichiers destinés à l’archivage. L’équipe devrait vérifier la fréquence des lectures, la classe de stockage choisie et le besoin métier. Un pic peut traduire un dysfonctionnement, mais aussi une activité attendue, comme une campagne de calcul. Le diagnostic suppose donc de connaître le calendrier des traitements.
Ce que cette évolution change dans l’écosystème IT
Le stockage relie ici plusieurs responsabilités : les équipes data construisent les traitements, les développeurs déterminent les accès, les administrateurs cloud suivent les ressources et la fonction FinOps examine les dépenses. FinOps désigne la gestion partagée des coûts et de la valeur des usages cloud. Pour une PME qui utilise déjà Cloud Storage, l’intérêt potentiel est de faciliter leurs échanges autour d’un même signal, avec un responsable identifié pour l’investigation.
Quatre signaux et quatre décisions à examiner
Les signaux ci-dessous sont documentés par Google. Les questions proposées servent à orienter l’analyse de l’organisation.[4]
| Signal observé | Effet possible | Vérification utile |
|---|---|---|
| Lectures accrues sur Coldline ou Archive | Des frais d’accès plus élevés. | La fréquence d’usage justifie-t-elle cette classe de stockage ? |
| Hausse des erreurs 429 | Des requêtes limitées et des traitements perturbés. | Quel processus augmente les requêtes et comment les répartir ? |
| Pic de transferts entre régions | Des dépenses de transfert supplémentaires. | Les données et les traitements sont-ils placés dans des régions adaptées ? |
| Croissance supérieure à la tendance | Un volume et un coût de stockage en hausse. | Les nouveaux objets répondent-ils à un besoin identifié et à une durée de conservation définie ? |
Passer du constat à une action validée
Les opérations par lots constituent la brique d’exécution : une organisation configure un traitement pour appliquer des transformations à un ensemble d’objets, puis en suit l’avancement. Elles prennent notamment en charge les changements de classe de stockage, certaines mises à jour de métadonnées et les suppressions. Le service gère l’exécution et les reprises automatiques des opérations en échec.[6]
Les évolutions de septembre ajoutent des filtres fondés sur les métadonnées, le traitement de plusieurs buckets et un mode de simulation, ou dry run. Ce dernier permet de vérifier la sélection avant l’exécution. Pour l’entreprise, le passage d’une recommandation à une modification étendue doit rester une décision explicite, avec un périmètre et un responsable.[2]
Ce qu’une organisation doit évaluer avant de l’adopter
L’accès au conseiller demande d’activer Storage Intelligence et de disposer des permissions adaptées. La documentation cite notamment le rôle Storage Admin, tout en permettant des rôles personnalisés. Le choix des droits mérite donc un examen : consulter un diagnostic et autoriser des modifications à grande échelle correspondent à des responsabilités différentes.[5]
Le calcul économique doit inclure les frais de Storage Intelligence et ceux des opérations effectuées. La tarification Standard comprend un coût de gestion lié au nombre d’objets, auquel peuvent s’ajouter d’autres frais d’usage. Un changement de classe peut lui-même entraîner des coûts de réécriture et, selon le cas, d’autres frais liés aux données. Une recommandation doit être évaluée sur le coût complet de la transition.[6], [7]
Avant un déploiement large, une expérimentation limitée permettrait de mesurer le temps d’investigation, la pertinence des constats et le coût des corrections. Toute suppression devrait être examinée avec le propriétaire métier des données et les règles de conservation de l’organisation. L’enjeu pratique est de réduire les opérations inutiles tout en maintenant les usages nécessaires.
Le pilotage du cloud commence par la compréhension des usages
La multiplication des volumes stockés renforce l’importance du Cloud Computing dans le pilotage quotidien des infrastructures. Le professionnel doit savoir interpréter une hausse des requêtes, identifier les traitements responsables et comprendre leurs conséquences sur les performances et les coûts.
Un signal inhabituel ne justifie pas automatiquement une correction : il peut correspondre à une activité attendue ou révéler un mauvais choix de configuration. La maîtrise du cloud consiste donc aussi à évaluer les effets d’un changement de classe de stockage, d’un déplacement de données ou d’une suppression avant d’agir.
Pour les entreprises, cette capacité permet de prendre des décisions adaptées aux besoins des applications, aux contraintes budgétaires et aux exigences de disponibilité. Le rôle du professionnel évolue ainsi vers un pilotage dans lequel chaque action technique doit être reliée à un besoin métier et à des effets mesurables.
La valeur dépendra des décisions prises après le signal
Storage Intelligence advisor apporte un point d’entrée pour examiner les écarts d’usage de Cloud Storage. Sa valeur devra se mesurer dans l’exploitation : les équipes trouvent-elles plus vite la cause d’un problème, évitent-elles des dépenses inutiles et appliquent-elles des corrections adaptées ? La question à suivre sera la capacité des organisations à installer cette boucle de suivi, avec des responsabilités claires et des résultats mesurés.
À LIRE AUSSI
Ces quatre analyses CCCLX prolongent les enjeux de coûts cloud, d’architecture des données et de besoins en stockage liés à l’IA.
Google Cloud s’attaque à la facture cachée des agents IA
Agentic Data Cloud : Google repense la data pour l’ère des agents IA
Databricks étend Delta Sharing à l’IA et veut casser les silos de données
+80 % : l’IA agentique provoque une flambée historique des SSD d’entreprise
Sources
- 01
Google Cloud, Hafid S. et Kohli H. (25 septembre 2026). Storage Intelligence advisor: Know what changed in your storage estate and act on it.
- 02
Google Cloud (2026). Cloud Storage release notes, entrées des 3 et 10 septembre.
- 03
Google Cloud. About Storage Intelligence advisor.
- 04
Google Cloud. Findings reference catalog for Storage Intelligence advisor.
- 05
Google Cloud. View Storage Intelligence advisor.
- 06
Google Cloud. Storage batch operations.
- 07
Google Cloud. Storage pricing.

RTX Spark : Nvidia accélère la transition vers les PC optimisés pour l’IA
Nvidia veut redéfinir le PC à l’ère de l’intelligence artificielle Présentée lors du Computex 2026, la puce RTX Spark marque une nouvelle étape dans l’évolution des ordinateurs personnels. Avec cette plateforme basée sur l’architecture Arm, Nvidia ne cherche pas...

La guerre des tokens commence : Headroom veut rendre l’IA moins coûteuse
L’intelligence artificielle se heurte à un nouveau défi : son coût L’adoption massive de l’intelligence artificielle générative transforme les entreprises, mais elle fait également émerger une nouvelle préoccupation : la maîtrise des coûts. Derrière chaque interaction...

Le WiFi 8 arrive plus vite que prévu : ce que cela change pour les entreprises
Une nouvelle génération de réseau se profile déjà Alors que le WiFi 7 commence à peine à se démocratiser dans les entreprises et chez les particuliers, l’industrie prépare déjà la prochaine étape. TP-Link vient de dévoiler le premier routeur compatible WiFi 8,...

Webedia-Elephant mise sur Gemini Enterprise pour industrialiser l’IA générative
Les interruptions IT deviennent un enjeu de direction générale Longtemps considérées comme de simples incidents techniques, les interruptions de service prennent aujourd’hui une tout autre dimension. Selon une étude menée par Oxford Economics pour Splunk, les...

600 milliards de dollars perdus : les pannes informatiques changent de dimension
Les interruptions IT deviennent un enjeu de direction générale Longtemps considérées comme de simples incidents techniques, les interruptions de service prennent aujourd’hui une tout autre dimension. Selon une étude menée par Oxford Economics pour Splunk, les...

Lightwell : IBM et Red Hat s’attaquent au casse-tête des patchs open source
L’IA découvre les failles plus vite que les entreprises ne peuvent les corriger L’intelligence artificielle transforme profondément la cybersécurité. Si elle permet de détecter plus rapidement les vulnérabilités, elle crée également un nouveau défi : la capacité à...
AWS renforce OpenSearch pour connecter l’IA aux données d’entreprise
Les agents IA obligent le cloud à évoluer L’essor de l’IA agentique transforme profondément les infrastructures cloud. Contrairement aux assistants conversationnels classiques, les agents intelligents doivent accéder à des données, interagir avec plusieurs systèmes et...
Avec Stainless, Anthropic veut intégrer Claude au cœur du développement logiciel
La bataille de l’IA se déplace vers les outils développeurs Anthropic poursuit sa montée en puissance dans l’intelligence artificielle avec le rachat de Stainless, une startup spécialisée dans les outils de développement et l’automatisation des API. Derrière cette...
Bousculé par la concurrence, Anthropic contre-attaque avec Claude Opus 4.8
La pression monte dans la course aux modèles d’IA Le marché de l’intelligence artificielle générative n’a jamais été aussi compétitif. Entre GPT-5 d’OpenAI, Gemini de Google, les avancées de Mistral et l’émergence de nouveaux acteurs comme DeepSeek, chaque évolution...
Dell Spark : Google prépare une IA capable d’agir à votre place
L’ère de l’assistant IA personnel commence Google franchit une nouvelle étape dans l’intelligence artificielle avec Spark, un agent IA personnel conçu pour agir de manière autonome dans la vie numérique des utilisateurs. Après les moteurs de recherche, les assistants...