


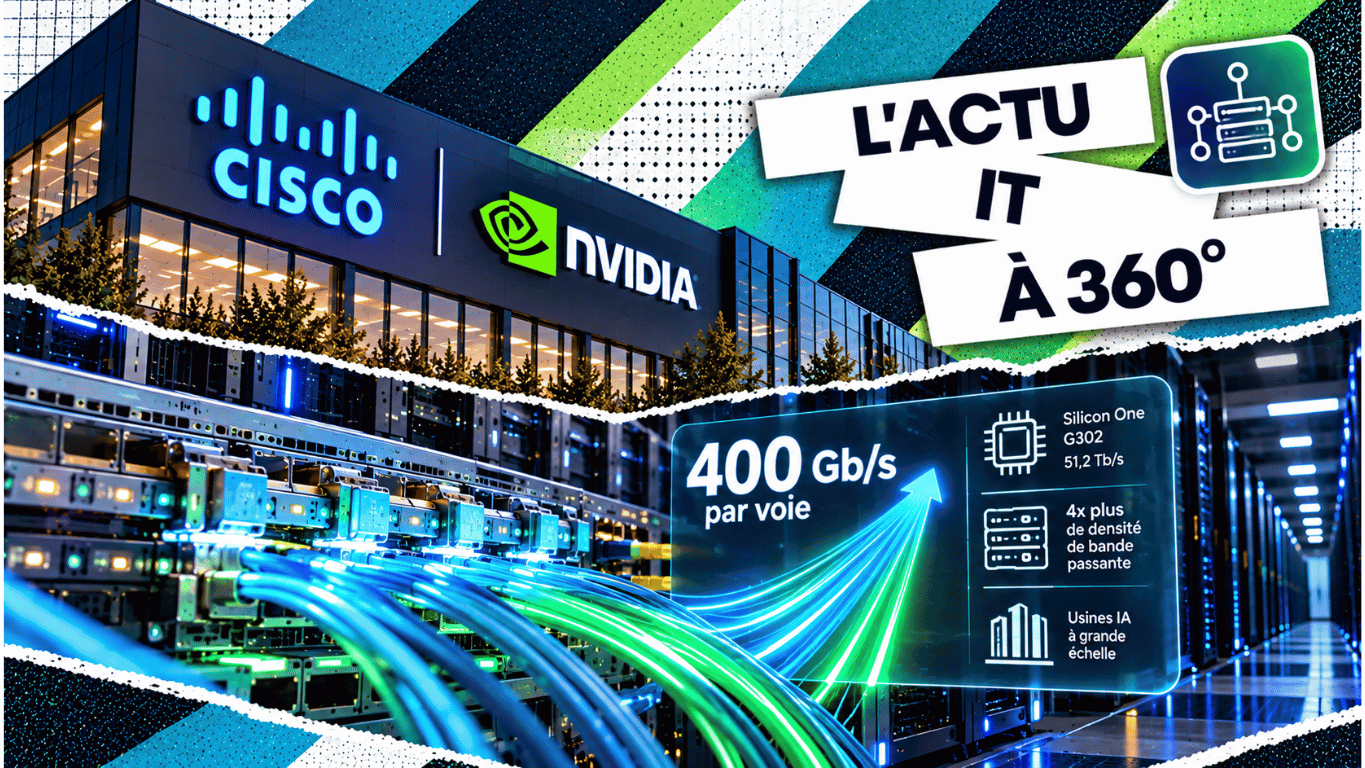
Cisco et NVIDIA annoncent un projet de format optique enfichable USFP, capable de prendre en charge 400 Gb/s par voie. Cisco présente aussi la puce de commutation Silicon One G302, à 51,2 Tb/s.[1] Ces annonces répondent à un enjeu des infrastructures IA : les accélérateurs doivent échanger suffisamment vite pour que la puissance de calcul installée soit réellement exploitable. Elles concernent toutefois des composants et des calendriers distincts.
Les GPU ont besoin de recevoir et de partager les données
Dans un traitement réparti sur plusieurs accélérateurs, une partie du travail dépend des échanges entre machines. Attendre des données ou les résultats d’un autre nœud peut ralentir l’ensemble du calcul. Ajouter des GPU ne suffit donc pas toujours à accélérer une tâche si le réseau ou le stockage limite déjà leur alimentation.
La difficulté consiste à localiser le goulot d’étranglement. Un lien saturé, une congestion ponctuelle, une mauvaise répartition des flux ou un stockage trop lent peuvent produire des symptômes proches. La réponse doit partir de mesures sur le travail réellement exécuté, avant de choisir un équipement plus rapide.
G302 équipe le réseau de baie tandis que USFP prépare les optiques
Le G302 vise les commutateurs de baie, qui relient les serveurs au réseau du datacenter. Cisco annonce des interfaces électriques SerDes à 200 Gb/s et prévoit les premières livraisons avant fin 2026.[1] Les 51,2 Tb/s désignent la capacité de commutation agrégée, pas le débit d’une connexion individuelle.
USFP, développé avec NVIDIA, est un projet de format de module optique. Les partenaires prévoient une spécification ouverte.[1] Il faut donc distinguer la puce présentée et cette évolution optique, plutôt que d’attribuer au G302 des voies à 400 Gb/s déjà disponibles.
Trois chiffres qui ne décrivent pas la même chose
Les débits s’expriment ici en bits par seconde. Une capacité agrégée ne correspond pas au débit utile garanti à une application.
| Indicateur | Ce qu’il décrit | Ce qu’il ne démontre pas |
|---|---|---|
| 51,2 Tb/s | Capacité de commutation du G302.[1] | Le débit accessible à chaque serveur. |
| 400 Gb/s par voie | Capacité visée par voie pour USFP.[2] | La disponibilité immédiate d’une liaison complète. |
| 6,4 Tb/s agrégés | 16 voies à 400 Gb/s dans le projet USFP.[2] | Une accélération équivalente des applications IA. |
La densité dépend aussi du nombre de voies
Le blog Cisco décrit 16 voies à 400 Gb/s, soit 6,4 Tb/s agrégés, et une évolution possible vers 32 voies et 12,8 Tb/s. Il compare cette proposition aux modules enfichables de 1,6 Tb/s pour annoncer une densité de bande passante multipliée par quatre.[2] Ce facteur ne résulte donc pas du seul doublement du débit par voie.
La maintenance compte autant que le débit maximal
Cisco met en avant le maintien de modules remplaçables sur le terrain et des pratiques d’exploitation des optiques enfichables.[2] Pour un opérateur, la possibilité d’intervenir sur un module peut peser dans le choix d’une architecture, au même titre que le débit ou la place occupée.
Une densité supérieure doit néanmoins être examinée avec les contraintes de refroidissement, de câblage et de disponibilité des pièces. Le nombre d’interventions, les délais de remplacement et les conditions de compatibilité peuvent modifier le coût réel d’une infrastructure sur plusieurs années.
Les gains énergétiques restent à mesurer sur le système complet
Cisco évoque une efficacité énergétique potentiellement améliorée d’environ 1,3 fois grâce aux SerDes à 400 Gb/s.[2] Cette indication ne signifie pas que la consommation totale d’un datacenter baissera dans la même proportion. Une capacité plus élevée peut également accompagner une hausse du volume de traitements.
Une comparaison utile doit préciser la charge, le débit effectivement transporté et le périmètre mesuré. Elle devrait inclure les équipements réseau, les optiques et le refroidissement. Les annonces consultées ne présentent pas de benchmark indépendant permettant de généraliser le gain à tous les environnements.
Une PME peut en tirer une méthode de dimensionnement
La plupart des PME n’ont pas besoin de préparer immédiatement un réseau à ces débits. En revanche, une organisation qui exploite plusieurs serveurs GPU ou achète une capacité de calcul distante doit comprendre ce qui limite ses traitements. Le réseau fait partie du service à évaluer, même lorsqu’il est administré par un fournisseur.
Un scénario illustratif consiste à comparer une même tâche sur un puis plusieurs serveurs, en observant la durée, l’utilisation des GPU et les échanges réseau. Si le gain de temps reste faible, l’équipe examine aussi le stockage et la répartition du travail. Ce test aide à poser un diagnostic ; il ne constitue pas une preuve que le réseau est nécessairement responsable.
La compétence IT à retenir : Administration systèmes et réseaux
Cette évolution mobilise directement l’Administration systèmes et réseaux. Le professionnel doit comprendre les chemins empruntés par les données et distinguer les débits théoriques des performances observées. Une capacité annoncée sur une fiche technique ne suffit pas à dimensionner un service.
Son rôle comprend l’analyse de la congestion, de la latence et des dépendances avec le stockage ou le calcul. Il doit aussi vérifier les interfaces, les modules optiques et les versions logicielles compatibles. Ces contrôles permettent d’éviter un investissement qui déplacerait simplement le goulot d’étranglement.
Enfin, l’administration du réseau implique la supervision et la reprise après incident. Les indicateurs doivent rendre visibles les dégradations avant qu’elles ne pénalisent durablement les traitements. La disponibilité d’un accès de maintenance et de procédures de remplacement reste essentielle, même sur une infrastructure très performante.
L’intérêt de USFP dépendra donc des performances mesurées sur les applications, de la compatibilité des équipements et des conditions d’exploitation. Pour dimensionner une infrastructure, il faut d’abord identifier les limites réelles du calcul, du réseau et du stockage.
Pour aller plus loin
Quatre lectures CCCLX sur les datacenters, les données et les infrastructures IA.
L’IA propulse Nokia : les datacenters redessinent le marché des réseaux
Google Cloud Storage Intelligence Advisor détecte les anomalies de stockage
Databricks étend Delta Sharing à l’IA et veut casser les silos de données
Agents vocaux IA : Oracle détaille une architecture LiveKit sur OCI
Sources
- 01
Cisco (12 octobre 2026). « Cisco Advances Scalability and Openness at OCP 2026 ». Annonce du commutateur Silicon One G302 et du projet de développement de USFP avec NVIDIA.
- 02
Gartner, B. et Eatherton, W., Cisco Blogs (12 octobre 2026). « Cisco and NVIDIA Announce USFP: Expanding the Path to AI Connectivity ». Détails sur les voies, la capacité agrégée et les gains annoncés pour le format USFP.

L’IA d’Anthropic progresse à un rythme qui inquiète les spécialistes de la cybersécurité
Les modèles d'IA franchissent un nouveau seuil de capacités À peine un mois après son lancement, Claude Mythos Preview continue déjà d'améliorer ses performances. Selon les derniers tests publiés par l'AI Security Institute (AISI) du Royaume-Uni, le modèle d'Anthropic...
Lumo AI 2.0 accélère sans sacrifier la protection des données
Proton veut prouver qu'une IA performante peut aussi être confidentielle La course à l'intelligence artificielle ne se joue plus uniquement sur les performances des modèles. La confiance des utilisateurs et la protection des données deviennent désormais des critères...
Azure Linux 4.0 : Microsoft prépare l’après Windows Server ?
Microsoft fait évoluer Linux bien au-delà du cloud Pendant longtemps, Azure Linux était une distribution conçue exclusivement pour faire fonctionner les infrastructures cloud de Microsoft. Avec la sortie d'Azure Linux 4.0, l'entreprise franchit une nouvelle étape en...
Claude Fable 5 quitte l’offre gratuite : Anthropic mise sur les usages professionnels
Anthropic réserve désormais son modèle le plus avancé À peine une semaine après la réouverture de Claude Fable 5, Anthropic change déjà de stratégie. L'entreprise met fin à son accès gratuit et réserve désormais son modèle le plus performant aux offres payantes...
Djinn Stealer : le malware qui s’attaque aux identifiants cloud et IA des entreprises
Les cybercriminels changent de cible Les cyberattaques ne visent plus uniquement les données ou les postes de travail. Les identifiants permettant d'accéder aux plateformes cloud, aux environnements d'intelligence artificielle et aux outils de développement sont...
Claude Tag transforme Slack en véritable espace de travail agentique
Les agents IA s'installent au cœur du travail collaboratif L'intelligence artificielle ne se limite plus aux assistants accessibles dans une fenêtre de discussion. Avec Claude Tag, Anthropic franchit une nouvelle étape en intégrant directement un agent IA dans Slack....
IBM et OpenAI veulent armer les entreprises contre les cyberattaques à vitesse machine
Les défenseurs doivent désormais combattre l'IA avec l'IA Les cyberattaques évoluent à une vitesse inédite. Grâce aux modèles d'intelligence artificielle, les attaquants sont capables d'automatiser la recherche de vulnérabilités, d'analyser du code en quelques...
La sécurité de l’open source change d’échelle : IBM, Red Hat et Palo Alto s’allient
Les cyberattaques poussent les géants de l'IT à unir leurs forces Les composants open source sont présents dans la quasi-totalité des applications modernes, des plateformes cloud aux logiciels métiers. Cette dépendance s'accompagne toutefois d'un risque croissant :...
Avec Lambda, AWS prépare l’infrastructure du cloud aux agents IA autonomes
Le serverless entre dans une nouvelle phase Le cloud évolue pour répondre aux besoins d'une nouvelle génération d'applications fondées sur l'intelligence artificielle agentique. À mesure que les agents IA deviennent capables d'exécuter des tâches complexes pendant...
La course aux semi-conducteurs s’accélère : IBM présente une architecture 0,7 nm
IBM veut repousser les limites des processeurs La compétition mondiale autour des semi-conducteurs franchit une nouvelle étape. IBM a dévoilé une architecture expérimentale baptisée Nanostack, capable d'empiler des transistors en trois dimensions à l'échelle de 0,7...