


Les agents IA obligent Google à repenser l’architecture des données
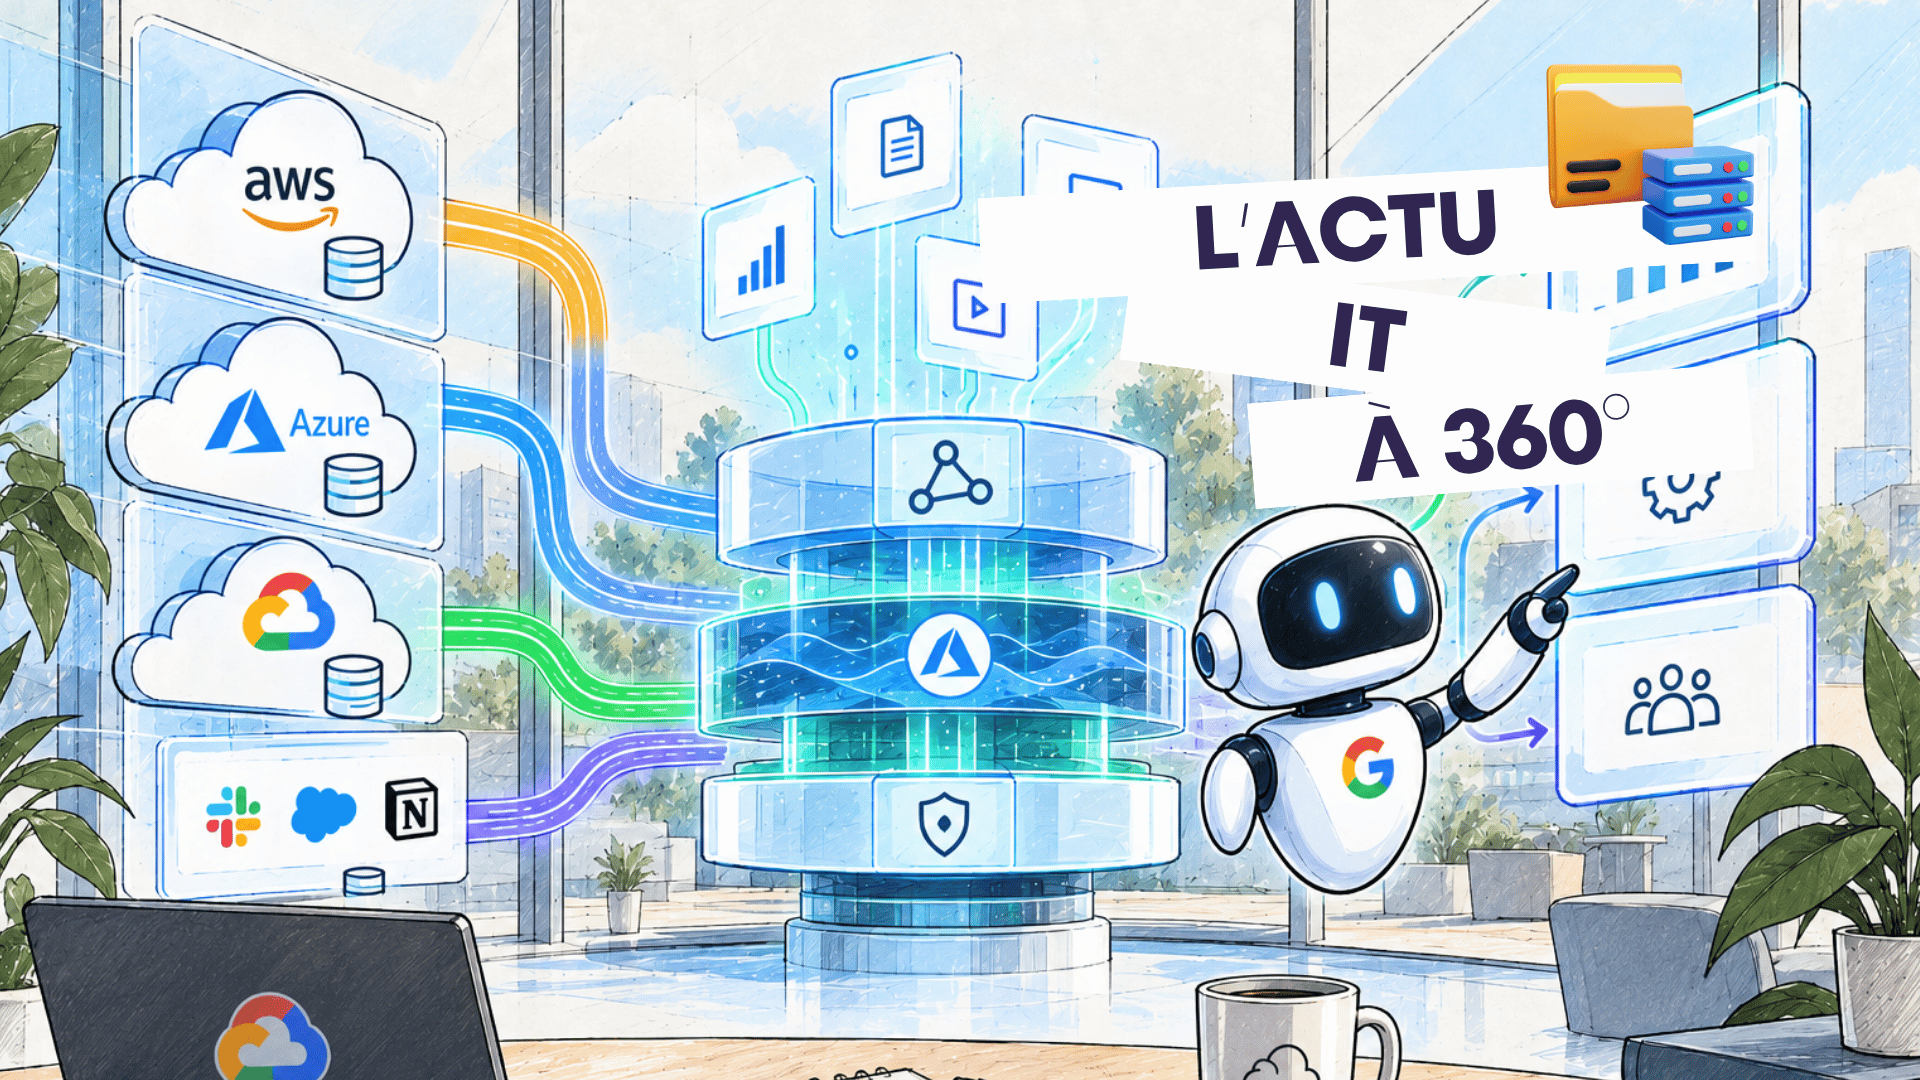
Les agents IA promettent de rechercher des informations, prendre des décisions et agir directement dans les systèmes de l’entreprise, mais cette autonomie repose sur une condition essentielle : accéder à la bonne donnée et surtout en comprendre le contexte. Google Cloud répond à ce défi avec son Agentic Data Cloud, une architecture AI-native destinée à faire évoluer les plateformes data traditionnelles vers ce que Google appelle un « System of Action », capable d’alimenter des agents qui perçoivent, raisonnent et agissent à partir des informations de l’organisation.¹ L’enjeu dépasse donc largement l’ajout de Gemini à une base de données : Google cherche à réunir données structurées et non structurées, métadonnées, règles métier, gouvernance et moteurs d’analyse afin que les agents puissent exploiter des informations dispersées sans devoir reconstruire leur contexte à chaque nouvelle tâche.
Un Cross-Cloud Lakehouse pour aller chercher la donnée là où elle se trouve
La première brique majeure de cette architecture est un Cross-Cloud Lakehouse basé sur Apache Iceberg, un format ouvert qui permet de conserver une architecture interopérable plutôt que d’enfermer les données dans un environnement propriétaire. Google Cloud veut permettre à ses moteurs et à ses agents d’accéder directement à des données hébergées dans d’autres clouds, notamment AWS et Azure, sans imposer leur migration préalable vers Google Cloud.² L’architecture peut notamment fédérer des catalogues comme AWS Glue, Databricks Unity Catalog et Snowflake Horizon, tandis que BigQuery et d’autres moteurs peuvent interroger les données distantes. Cette logique est particulièrement importante pour les grandes entreprises dont le patrimoine informationnel est déjà réparti entre plusieurs clouds, data warehouses, lakehouses et applications SaaS : demander à un agent d’agir à l’échelle de l’organisation suppose qu’il puisse franchir ces silos sans multiplier les copies et les pipelines ETL.
Google veut éviter de déplacer des pétaoctets pour alimenter une IA
Cette approche répond également à un problème économique et opérationnel. Déplacer continuellement d’importants volumes de données entre plusieurs clouds entraîne des coûts d’egress, ajoute de la latence et oblige les équipes à maintenir des pipelines supplémentaires. Avec son architecture cross-cloud, Google s’appuie notamment sur Cross-Cloud Interconnect, la fédération des catalogues Iceberg et des mécanismes de cache pour permettre aux moteurs d’analyse de travailler sur des données distantes sans reproduire systématiquement les fichiers.² Pour un agent, cette capacité peut devenir déterminante : une mission complexe peut nécessiter de croiser des données commerciales dans un environnement, des données opérationnelles dans un autre et des informations issues d’applications métiers, parfois en quelques secondes. L’architecture data devient alors une condition directe de l’autonomie de l’IA.
Le Knowledge Catalog veut donner du sens aux données de l’entreprise
Accéder à toutes les données ne suffit pourtant pas. Un agent peut retrouver une colonne appelée « marge » sans savoir si elle correspond à une marge brute, nette, prévisionnelle ou calculée selon une règle particulière à l’entreprise. C’est précisément le rôle du Knowledge Catalog, évolution du Dataplex Universal Catalog, que Google présente comme un moteur de contexte universel pour les agents.¹ Il agrège les métadonnées provenant des environnements Google Cloud et de plateformes partenaires, enrichit continuellement leur signification à partir des usages et exploite notamment Gemini pour extraire du sens de contenus non structurés et générer certaines informations sémantiques manquantes. Google associe également cette couche à Looker, LookML et BigQuery Measures afin d’intégrer davantage de logique métier dans le contexte accessible aux agents. L’objectif est de transformer le catalogue de données traditionnel, longtemps utilisé pour inventorier et gouverner les actifs, en une couche active permettant à l’IA de comprendre ce qu’elle manipule.
La gouvernance devient une partie du raisonnement de l’agent
Cette contextualisation doit également respecter les droits d’accès. Google indique que la recherche du Knowledge Catalog tient compte des contrôles d’accès afin qu’un agent ne puisse retrouver et exploiter que les actifs auxquels il est autorisé à accéder.¹ Cette dimension est essentielle lorsque les agents commencent à dépasser la simple génération de texte pour intervenir dans les opérations : une IA chargée d’analyser les ventes ne doit pas automatiquement obtenir accès aux dossiers RH ou à des informations financières confidentielles simplement parce que ces données appartiennent au même lakehouse. La gouvernance doit donc suivre l’information depuis sa découverte jusqu’à son utilisation par l’agent, avec des éléments comme la qualité, le lineage, les permissions et la signification métier. L’Agentic Data Cloud rapproche ainsi deux disciplines qui ont longtemps été traitées séparément, la gouvernance des données et la gouvernance des systèmes d’IA.
Sans contexte fiable, un agent reste aveugle
Cette évolution transforme directement la Gestion des données. Les Data Engineers et professionnels de la data ne préparent plus seulement des tables destinées aux analystes, aux tableaux de bord ou aux modèles de machine learning : ils doivent désormais construire une information suffisamment fiable et contextualisée pour qu’un agent puisse l’interpréter sans intervention humaine constante. Qualité des données, métadonnées, modèles sémantiques, catalogage, lineage et politiques d’accès deviennent donc des éléments constitutifs du raisonnement de l’IA. Une mauvaise définition métier ou une donnée obsolète peut désormais provoquer non seulement une mauvaise analyse, mais aussi une mauvaise action si l’agent utilise cette information pour déclencher automatiquement une opération. Dans l’entreprise agentique, la qualité de la décision de l’IA dépend directement de la qualité de l’architecture data qui l’alimente.
La bataille des agents devient aussi une bataille des architectures data
Google ne cherche donc plus uniquement à proposer des modèles plus performants. Avec l’Agentic Data Cloud, le groupe veut contrôler une partie beaucoup plus large de la chaîne qui relie l’information à l’action : stockage, bases de données, lakehouse, analytics, contexte métier, recherche, gouvernance, modèles Gemini et plateforme agentique. Cette stratégie reflète une évolution importante du marché : les entreprises pourraient découvrir que leurs difficultés à industrialiser les agents viennent moins des capacités des modèles que de données fragmentées, mal documentées ou difficiles à connecter aux systèmes d’IA. Une étude Google Cloud publiée en 2026 indique d’ailleurs que 43 % des responsables IT interrogés considèrent les difficultés d’intégration avec les API legacy et les sources de données comme leur principal déficit infrastructurel pour l’IA agentique.³
La prochaine infrastructure critique pourrait être celle qui donne du contexte à l’IA
L’Agentic Data Cloud montre finalement que l’ère des agents ne se résumera pas à multiplier les assistants autonomes. Pour qu’un agent puisse gérer un processus commercial, analyser une chaîne logistique ou intervenir dans une application métier, il doit savoir où se trouve l’information, ce qu’elle signifie, si elle est suffisamment fiable et s’il possède le droit de l’utiliser. Le Cross-Cloud Lakehouse répond au problème de l’accès à des données distribuées, tandis que le Knowledge Catalog cherche à fournir la couche de contexte et de gouvernance nécessaire à leur interprétation. Google Cloud parie ainsi sur une idée simple mais structurante : dans la prochaine phase de l’IA d’entreprise, l’avantage ne viendra peut-être pas seulement de celui qui possède le meilleur agent, mais de celui qui sera capable de lui fournir les données les plus fiables et le contexte métier le plus précis.
L’Actu IT à 360° — décrypter la technologie pour comprendre les métiers de demain.
Pour aller plus loin
Cette évolution prolonge une transformation déjà visible dans les architectures data modernes. Découvrez notre article CCCLX « AWS renforce OpenSearch pour connecter l’IA aux données d’entreprise », consacré à un autre enjeu central de l’IA professionnelle : permettre aux modèles et aux applications intelligentes de retrouver et d’exploiter efficacement les informations dispersées dans les systèmes de l’organisation.
Références
1. Google Cloud. (2026). What's new in the Agentic Data Cloud: Powering the System of Action.
https://cloud.google.com/blog/products/data-analytics/whats-new-in-the-agentic-data-cloud
2. Google Cloud. (2026). The future of data lakehouse: Open and interoperable for the agentic era.
https://cloud.google.com/blog/products/data-analytics/the-future-of-data-lakehouse-for-the-agentic-era
3. Google Cloud. (2026). State of AI infrastructure report and the Agentic Data Cloud.
https://cloud.google.com/blog/topics/ai-infrastructure/state-of-ai-infrastructure-report-and-the-agentic-data-cloud
4. Google Cloud. (2026). About cross-cloud data access.
https://docs.cloud.google.com/lakehouse/docs/about-cross-cloud-data-access
Salesforce veut acquérir Loops pour aider Tableau à expliquer les variations des KPI
Salesforce annonce un accord définitif pour acquérir Loops, une plateforme analytique fondée sur l’IA, avec l’intention d’intégrer sa technologie à Tableau après la clôture.[1] L’objectif est de surveiller les indicateurs et de faire ressortir les facteurs associés à...
Cisco et NVIDIA préparent des connexions optiques à 400 Gb/s par voie pour les infrastructures IA
Cisco et NVIDIA annoncent un projet de format optique enfichable USFP, capable de prendre en charge 400 Gb/s par voie. Cisco présente aussi la puce de commutation Silicon One G302, à 51,2 Tb/s.[1] Ces annonces répondent à un enjeu des infrastructures IA : les...
Une nouvelle année commence chez CCCLX !
Le campus de Paris-Villejuif accueille les étudiants de CCCLX pour une nouvelle année d’apprentissages, de projets et d’expériences au cœur de l’IT à 360°.
VMware HyperArmor renforce la protection de l’hyperviseur contre les cyberattaques
Broadcom présente VMware HyperArmor, une solution destinée à protéger l’hyperviseur ESX de VMware Cloud Foundation, avec une prise en charge annoncée d’ESX 8.x et des versions ultérieures.[1] L’enjeu dépasse la sécurité d’une application : l’hyperviseur constitue un...
Microsoft Oracle et Marvell veulent intégrer un coffre-fort cryptographique aux serveurs
Marvell, Microsoft et Oracle annoncent un groupe de travail au sein de l’Open Compute Project pour définir des spécifications ouvertes de HSM intégré au serveur. Le projet vise le niveau FIPS 140-3 Level 3.[1] Derrière cette annonce matérielle se trouve un enjeu...
Workday veut rendre ses agents accessibles depuis Claude Copilot Gemini Teams et Slack
Workday annonce l’extension de Sana, son expérience agentique et moteur d’orchestration, aux outils conversationnels utilisés par les salariés.[1] L’ambition est de permettre des opérations RH et financières depuis ces points d’entrée. Pour les entreprises, la...
SolarWinds Avior les équipes IT fixent les objectifs et les agents coordonnent les actions
SSolarWinds lance Avior, un système d’IA agentique conçu pour poursuivre des objectifs opérationnels dans les environnements IT hybrides. Disponible depuis le 14 octobre dans le cadre d’un accompagnement au démarrage, il associe des agents spécialisés à des mécanismes...
GitHub renforce la détection et la correction des failles avec AI Scan et Agentic Autofix
GGitHub annonce la disponibilité générale d’AI Scan for pull requests et d’Agentic Autofix pour les alertes de code scanning.[1][2] Ces fonctions rapprochent l’assistance IA du travail de sécurisation du code. Elles interviennent toutefois sur des périmètres...
Cloudflare rend la sécurité web programmable avec Workers
CCloudflare rapproche sa passerelle web sécurisée de sa plateforme de développement Workers. Avec Forward, disponible en bêta publique, les entreprises peuvent ajouter du code au traitement de certaines requêtes HTTP autorisées.[2] Pour les équipes IT, cette...
Palo Alto Networks renforce la sécurité des agents IA autour de Claude Enterprise
PPalo Alto Networks présente plusieurs évolutions de Prisma AIRS : protection des interactions avec Claude Enterprise, analyse des composants utilisés par les agents et contrôle des échanges avec leurs outils.[1] L’enjeu est concret pour les entreprises : éviter qu’un...