

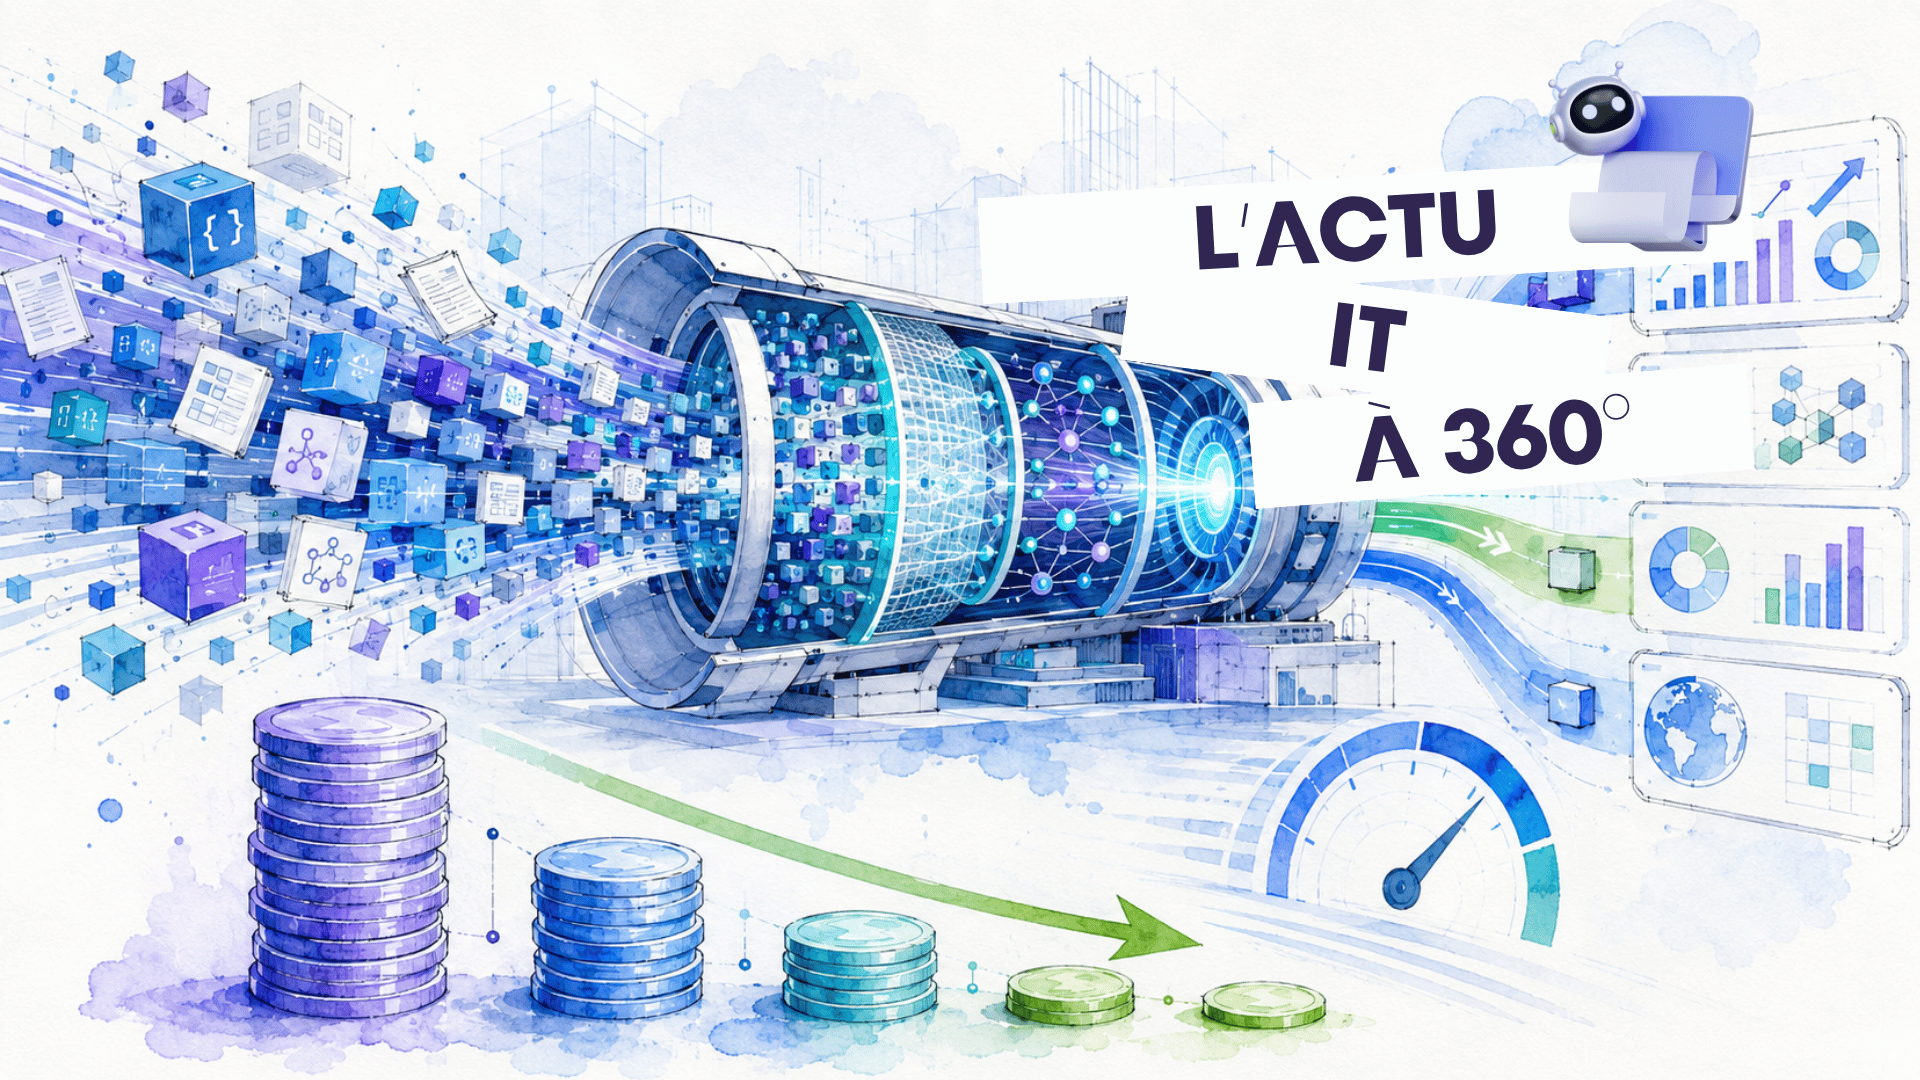
La course à l’IA se déplace désormais vers les coûts
Après plusieurs années pendant lesquelles les éditeurs se sont principalement affrontés sur la puissance de leurs modèles, une nouvelle bataille s’ouvre autour de leur coût d’exploitation. Writer vient de lancer Palmyra X6, son nouveau modèle phare destiné aux usages agentiques en entreprise, avec une promesse particulièrement concrète : permettre aux organisations de déployer davantage d’agents IA sans voir leur consommation de tokens exploser. Associé aux améliorations apportées à la plateforme Writer Agent, Palmyra X6 permettrait selon l’entreprise de réduire en moyenne de 52 % le coût d’exécution des agents, tout en améliorant leur vitesse de 48 % et leur qualité de 10 %.¹ Derrière ces chiffres se dessine un changement important pour l’IA d’entreprise : la performance d’un modèle ne suffit plus, son efficacité économique devient un critère déterminant lorsqu’il doit exécuter quotidiennement des milliers de tâches.
Les agents IA font exploser la consommation de tokens
Un chatbot classique traite généralement une demande puis génère une réponse, tandis qu’un agent peut raisonner pendant plusieurs étapes, interroger des documents, utiliser des outils, appeler des API, déléguer certaines opérations à d’autres agents puis vérifier le résultat obtenu. Chacune de ces actions consomme des tokens et, lorsqu’un workflow est répété à grande échelle, quelques centimes supplémentaires par tâche peuvent rapidement représenter des budgets considérables. Writer considère donc que le véritable indicateur à surveiller n’est plus seulement le prix d’un million de tokens, mais le coût nécessaire pour accomplir une tâche complète. Dans ses évaluations, Palmyra X6 affiche un tarif de 2 dollars par million de tokens en entrée et 8 dollars en sortie, tandis que Writer annonce un temps moyen de réalisation d’une tâche de 26 secondes et une capacité à poursuivre un objectif pendant jusqu’à huit heures.¹
Palmyra X6 mise sur l’efficacité plutôt que sur la taille
Writer n’a pas conçu Palmyra X6 à partir de zéro. Le modèle repose sur GLM-5.2, un modèle à poids ouverts de Z.ai, auquel l’entreprise a appliqué un post-entraînement spécifiquement orienté vers les usages agentiques professionnels.² Le rapport technique publié par les chercheurs de Writer décrit notamment une méthode d’Anchored Supervised Fine-Tuning reposant sur un ensemble compact de trajectoires vérifiées d’utilisation d’outils, avec l’objectif de renforcer les capacités agentiques sans dégrader les compétences générales du modèle. Cette approche illustre une tendance de plus en plus visible dans l’industrie : plutôt que de construire systématiquement un modèle toujours plus massif, les fournisseurs cherchent à optimiser des modèles existants pour des tâches précises, avec un meilleur compromis entre performance, vitesse et coût.
Le véritable levier d’économie se trouve aussi autour du modèle
Palmyra X6 n’est pourtant qu’une partie de la stratégie de Writer. L’entreprise a également profondément optimisé son Agent Harness, la couche d’orchestration qui détermine comment un agent assemble son contexte, utilise ses outils, délègue certaines tâches et organise ses différentes étapes de raisonnement. Une étude menée par Writer sur six modèles et 22 tâches professionnelles montre qu’en conservant les mêmes modèles mais en remplaçant une boucle agentique classique par son harness optimisé, le coût moyen par tâche est passé de 0,21 à 0,12 dollar, tandis que la consommation moyenne est passée de 14 200 à 8 800 tokens et que le temps médian d’exécution est passé de 48 à 27 secondes.³ La qualité globale est restée proche, ce qui suggère qu’une partie importante des économies peut provenir de l’architecture entourant le modèle plutôt que du modèle lui-même.
Writer veut empêcher les agents de devenir des gouffres financiers
Cette optimisation devient particulièrement importante lorsque les entreprises commencent à déployer des agents sur des processus métiers complets. Writer cible notamment les équipes marketing et commerciales qui utilisent l’IA pour rechercher des informations, générer du contenu, exploiter des connaissances internes ou automatiser des workflows complexes. L’entreprise ajoute également des outils de gouvernance permettant aux responsables IT de suivre la consommation de tokens et de mieux contrôler les dépenses associées aux agents.¹ Cette dimension financière pourrait devenir déterminante à mesure que l’utilisation de l’IA se généralise : un prototype performant peut facilement être validé avec quelques utilisateurs, mais son équation économique change radicalement lorsqu’il doit fonctionner quotidiennement pour plusieurs milliers de collaborateurs.
Déployer une IA, c’est aussi apprendre à maîtriser sa facture
Cette évolution met en lumière une nouvelle dimension des Intelligences Artificielles génératives. Les professionnels ne doivent plus seulement savoir choisir un modèle ou construire un prompt efficace, ils doivent comprendre comment les tokens sont consommés, comment organiser le contexte transmis au modèle et comment orchestrer les appels aux différents outils sans multiplier inutilement les opérations. Le choix d’un modèle plus puissant n’est donc pas systématiquement la meilleure solution : selon le workflow, une architecture mieux optimisée peut permettre d’obtenir un résultat comparable avec beaucoup moins de ressources. Pour les équipes IT, savoir mesurer le coût par tâche, surveiller la consommation et concevoir des workflows agentiques efficaces devient ainsi une compétence directement liée à la capacité de déployer l’IA à grande échelle.
Après les benchmarks, la bataille du coût par tâche commence
Avec Palmyra X6, Writer défend finalement une idée simple : une IA réellement utilisable en entreprise doit être performante, mais également économiquement soutenable. À mesure que les agents deviennent capables de travailler plus longtemps, d’utiliser davantage d’outils et d’enchaîner des dizaines d’actions, leur consommation devient un élément central de l’architecture. La prochaine étape de la compétition entre fournisseurs pourrait donc se jouer moins sur quelques points supplémentaires dans un benchmark que sur la capacité à accomplir une mission professionnelle au meilleur coût, avec une latence maîtrisée et un niveau de fiabilité suffisant. Palmyra X6 montre ainsi que l’industrialisation de l’IA générative entre dans une nouvelle phase, celle où l’efficacité technique doit désormais s’accompagner d’une véritable efficacité économique.
L’Actu IT à 360° — décrypter la technologie pour comprendre les métiers de demain.
Pour aller plus loin
Réduire la facture de l’IA ne dépend pas uniquement du modèle utilisé, mais aussi de la manière dont les données et le contexte sont traités. Découvrez notre article CCCLX « La guerre des tokens commence : Headroom veut rendre l’IA moins coûteuse », qui analyse une autre approche destinée à limiter la consommation de tokens et à rendre les applications d’intelligence artificielle plus efficaces.
Références
1. Writer. (2026). WRITER Makes Agentic AI Economically Sustainable at Enterprise Scale With Palmyra X6 Release and Major Harness Upgrades.
https://writer.com
2. Writer Research. (2026). Palmyra X6 Technical Report: An Agentic, Tool-Use Model Post-Trained via Anchored Supervised Fine-Tuning.
https://arxiv.org/abs/2608.16620
3. Writer Research. (2026). The Harness Effect: How Orchestration Design Sets the Token Economics of Enterprise Agentic AI.
https://arxiv.org/abs/2607.06906
Salesforce branche Claude sur son CRM : Claudeforce prépare l’après-interface
Et si le CRM n’avait bientôt plus besoin d’être ouvert ? Pendant des décennies, utiliser un CRM signifiait naviguer entre des fiches clients, des tableaux de bord, des menus et des formulaires. Avec Claudeforce, Salesforce et Anthropic veulent modifier cette logique :...
Enterprise AI Harness : Salesforce s’attaque au chaos des agents IA
Les agents se multiplient, leur contrôle devient le nouveau problème des entreprises Les entreprises commencent à déployer des agents IA dans le support client, les ventes, la finance, les RH ou encore le développement logiciel, mais cette multiplication crée un...
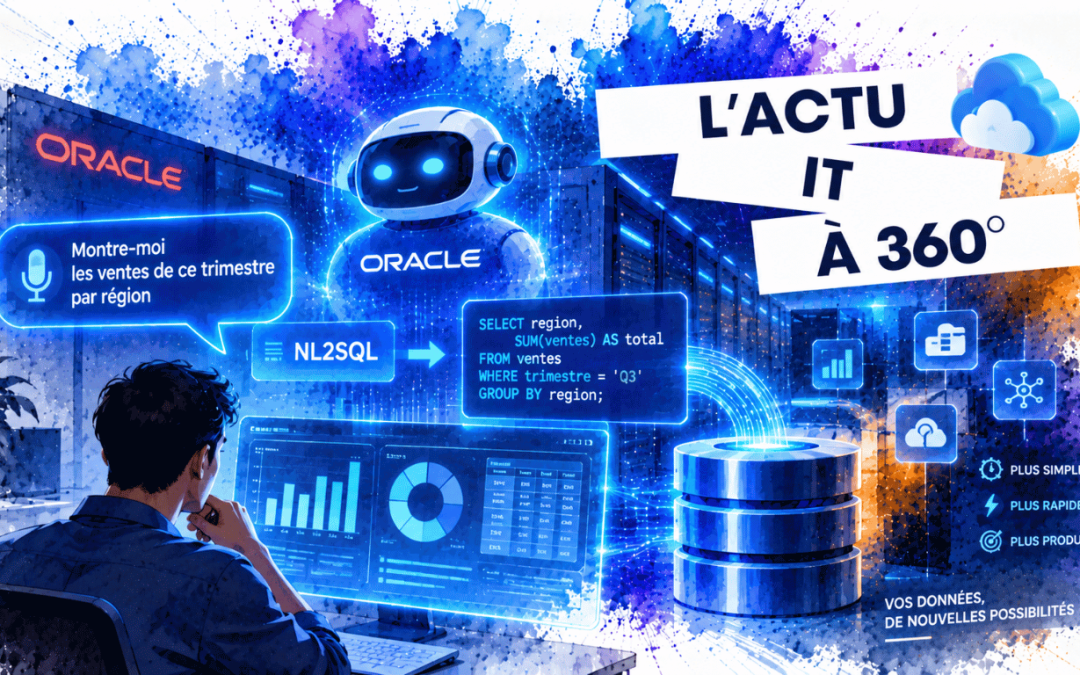
Parlez à votre base de données : Oracle améliore son IA NL2SQL
Oracle veut rapprocher les utilisateurs métiers de leurs données Interroger une base de données d'entreprise nécessite traditionnellement de connaître sa structure et de maîtriser SQL, ce qui laisse souvent les équipes métiers dépendantes des analystes ou des...
Kimi K3, Mistral, DeepSeek : Oracle transforme OCI en hub de modèles IA
Oracle veut faire d’OCI un guichet unique pour l’IA Oracle accélère dans la bataille du cloud IA en élargissant fortement le catalogue de modèles disponibles dans OCI Enterprise AI. Le 4 septembre 2026, le groupe a notamment annoncé l’intégration de Kimi K3, le modèle...
Agentic Data Cloud : Google repense la data pour l’ère des agents IA
Les agents IA obligent Google à repenser l'architecture des données Les agents IA promettent de rechercher des informations, prendre des décisions et agir directement dans les systèmes de l'entreprise, mais cette autonomie repose sur une condition essentielle :...
Google Cloud s’attaque à la facture cachée des agents IA
Les agents IA posent un nouveau problème : combien coûte réellement une tâche ? À mesure que les entreprises passent des chatbots aux agents IA capables de travailler pendant plusieurs étapes, la question du coût devient beaucoup plus complexe. Un chatbot traite...
Workday, Navan, Avalara : ChatGPT Work s’invite dans les logiciels métiers
ChatGPT Work quitte progressivement la fenêtre de chat Avec GPT-6 Astra, OpenAI ne cherche plus seulement à améliorer la qualité des réponses produites par ChatGPT. L'entreprise veut rapprocher son IA des applications dans lesquelles les salariés travaillent...
GPT-6 Astra arrive sur Amazon Bedrock : OpenAI s’installe dans le cloud d’entreprise
OpenAI trouve une nouvelle porte d'entrée dans les entreprises Le 8 septembre 2026, AWS a annoncé la disponibilité générale de GPT-6 Astra sur Amazon Bedrock, donnant aux entreprises une nouvelle manière d'accéder au modèle le plus avancé d'OpenAI directement depuis...
De la puce au cloud : Groq lève 350 millions pour changer d’échelle
Groq veut désormais vendre du cloud plutôt que seulement des puces Groq poursuit une transformation stratégique majeure. Longtemps identifié comme l'un des challengers de Nvidia grâce à ses LPU (Language Processing Units) spécialisés dans l'inférence des modèles...
Muse Code : Meta lance son agent IA pour s’attaquer aux codebases géantes
Meta veut faire entrer les agents IA dans les projets logiciels complexes Meta accélère dans le développement logiciel assisté par intelligence artificielle avec Muse Code, un nouvel agent pensé pour intervenir sur de grandes codebases, là où les assistants...